
The task involves creating an HTML snippet defining standard deviation, including its formula and practical examples, adhering to specified formatting constraints. Focusing on content first, it is necessary to explain the core concept, mathematical representation, and real-world application examples.
Initial focus is on integrating the FAQ section. The instruction to apply a specific light blue theme color to key content within the FAQ is noted. The task requires adhering to CSS restrictions, particularly avoiding `max-width`, `width`, `max-height`, and `height` constraints on content containers. It is important to remember to avoid forbidden words. A missing H1 or title should be added if not violating the prompt rule to avoid including a title at the opening of an article.
I'm thinking through how to approach this.
Focusing on content revisions, ensuring financial volatility and return explanations include clarifications about historical volatility versus future drawdowns, along with a prominent disclaimer. Examples will be clearly labeled as hypothetical. Terminology will be unified, particularly "總體(母體)." The definition of standard deviation as root mean square deviation will be explicitly stated.
The FAQ section will be strictly placed as the final section of the article, confirming rule compliance. The conclusion or takeaway should precede the FAQ, maintaining the correct sequence. Reviewing the article for forbidden words and CSS constraints related to sizing is the next step.
Considering the specified structure, a detailed outline is being constructed to ensure all required components are included in the correct sequence. The color palette and highlighting conventions will be integrated throughout, focusing on accurate representation of standard deviation concepts and applications. Real-world examples will be incorporated to illustrate the practical relevance.
這篇說明首先會定義 `標準差` 和 `變異數(Variance)`,並區分 `總體標準差` 和 `樣本標準差`,包括 `貝塞爾校正(Bessel's correction)` 的解釋。
會提及 `68-95-99.7 法則` 和 `變異係數(CV)`、`四分位距(IQR)` 等概念,並納入教育評估和金融領域的應用說明。在教育評估中,將說明香港公開考試(HKDSE)的統計方式。金融範例將包含免責聲明,強調歷史波動率不等於未來虧損預測。
每次派發成績單,常有家長提出同一個疑問:「孩子考了 70 分,表現算好還是算差?」這個問題單看分數無法給出答案,關鍵在於全班整體的分數分佈。如果全班平均分是 68 分,且大部分同學的分數都落在 65 至 72 分之間,那麼 70 分就是穩定的中游水平;但如果全班平均依然是 68 分,分數卻從 20 分一路分散到 100 分,70 分所代表的位置與意義就完全不同。
同一個分數,意義截然不同。差異的核心不在於數值本身,而在於數據散佈的寬度。標準差(Standard Deviation)正是統計學中專門用來量化「數據分散程度」的核心工具。
在實際應用中,標準差猶如一把衡量「不確定性」與「波動程度」的精密尺規:金融投資者用它評估資產波幅,工廠品質工程師用它檢驗產線穩定度,醫學研究人員用它確認藥物療效的一致性。
標準差的本質:概念與物理意義
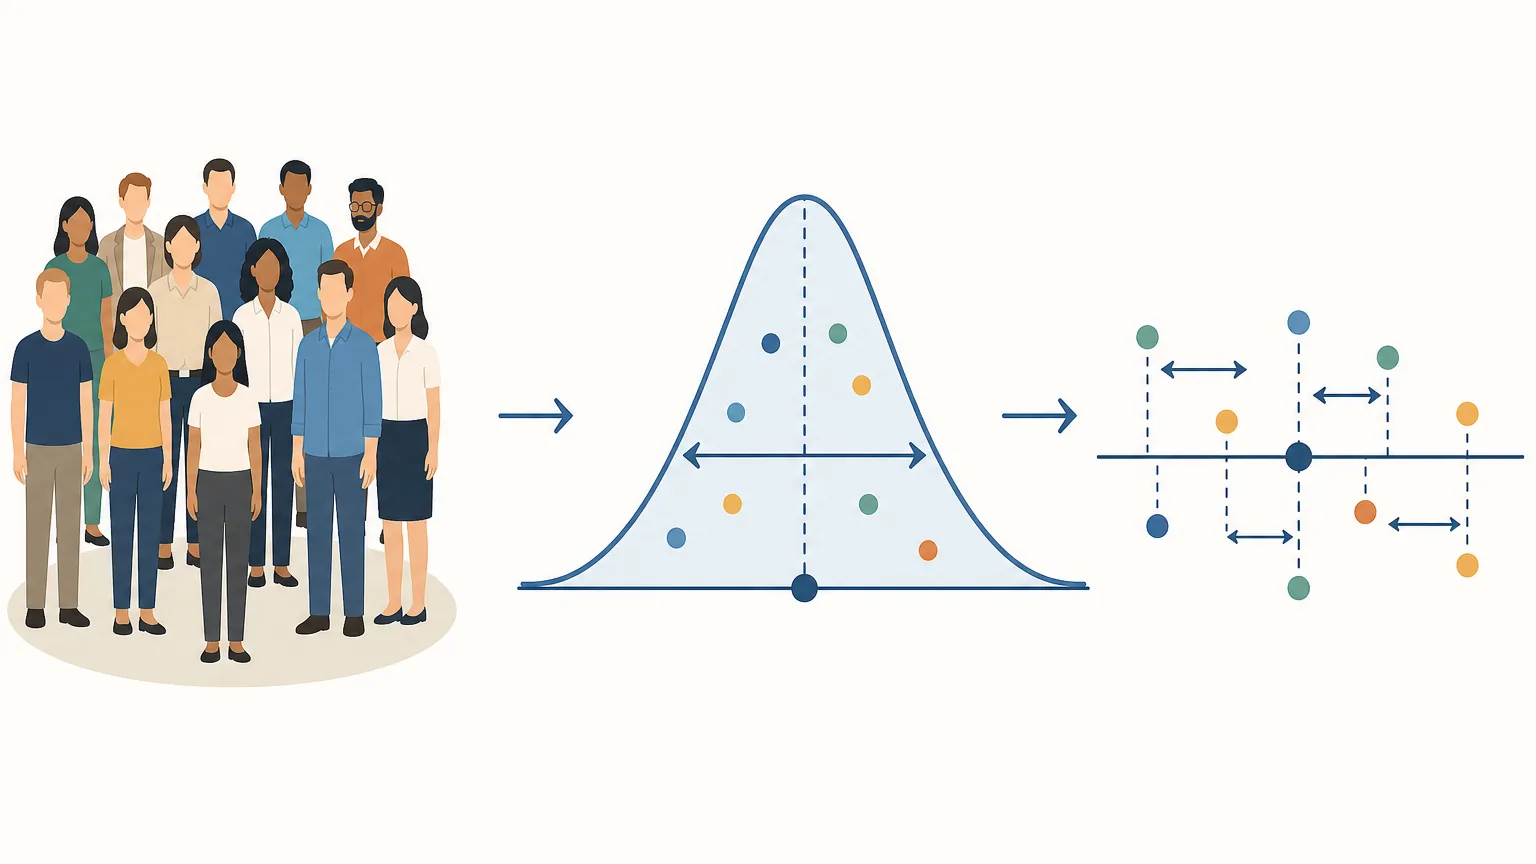
標準差是衡量一組數值偏離其平均數程度的統計指標。嚴格來說,它是各數據點與平均數差距的均方根距離(RMS),用來具體描述數據點平均距離中心位置有多遠。
標準差數值越小,代表數據點越密集地靠攏在平均數周圍;標準差數值越大,代表數據分佈越分散,極值出現的機率也較高。
標準差的一大優勢在於:它的計量單位與原始數據完全相同。如果原始數據單位是「公斤」,標準差就是「公斤」;數據是「港元」,標準差就是「港元」。這項特性讓標準差可以直接與平均數並列解讀。例如某職位平均月薪為 25,000 港元、標準差為 3,000 港元,便能直觀理解薪資核心區間大概坐落於 22,000 至 28,000 港元之間。
為何只看平均數容易產生盲點
平均數僅能指出數據的「集中中心」,卻完全無法反映周圍數值的「離散狀態」。若僅依賴平均數做決策,往往會掩蓋潛在的極端波動與品質問題。
舉一個製造業的具體案例:假設有兩條生產線同時生產直徑規格為 10 毫米的軸承零件(以下為示意數據):
- A 產線連續五件成品直徑:9.9、10.0、10.0、10.1、10.0 毫米(平均數:10.0 毫米)
- B 產線連續五件成品直徑:9.5、10.5、9.8、10.2、10.0 毫米(平均數:10.0 毫米)
兩條產線的平均值完全相同,但 A 產線各批次極度穩定,B 產線卻出現顯著公差偏差。若依總體公式計算,A 產線的標準差約為 0.06 毫米,B 產線則約為 0.34 毫米,兩者離散程度相差達五倍以上。單看平均數會誤判兩者品質一致,唯有納入標準差,才能精準挑選出穩定度合格的生產線。
變異數與標準差的運算關聯
理解標準差之前,需要先釐清其前置指標:變異數(Variance,又稱方差)。
計算離散程度時,若直接將每個數據與平均數的離差(差距)相加,正負離差會相互抵消導致總和為零。為了消除正負號影響,統計學將每組差距進行「平方」後加總再取平均,所得數值即為變異數。
然而,平方運算會改變原始測量單位(例如「毫米」轉變為「平方毫米」),導致無法直觀與原始平均值進行加減比較。因此,將變異數取正平方根,使單位回歸原始基準,所得的結果就是標準差。
公式解析:總體標準差 vs 樣本標準差
在實際計算中,必須依據手頭持有的數據範圍,區分使用總體標準差(母體標準差)或樣本標準差。
1. 總體標準差(Population Standard Deviation)
當蒐集到的數據包含研究對象的全部完整個體時,使用希臘字母 σ(讀作 sigma)表示:
符號說明:xᵢ 代表個別數據,μ 代表總體平均數,N 代表總體總筆數,Σ 代表總和。
2. 樣本標準差(Sample Standard Deviation)
當手頭數據僅是由母體中隨機抽樣所得的一部分代表時,使用英文字母 s 表示:
符號說明:x̄ 代表樣本平均數,n 代表樣本數。
為何樣本公式的分母是 n − 1?
樣本平均數 x̄ 本身是利用抽樣數據計算而來的中心點,樣本點圍繞 x̄ 的分散距離,天生會比圍繞真實總體平均數 μ 的距離更近。若分母直接除以 n,會系統性地低估總體的真實分散程度。將分母縮小為 n − 1 可以適度放大估計值,修正此一偏差,這在統計學上稱為貝塞爾校正(Bessel's correction)。
逐步手算示範
以一組五個數值為例逐步演示計算流程:4、8、6、5、7。
- 計算平均數:(4 + 8 + 6 + 5 + 7) ÷ 5 = 30 ÷ 5 = 6。
- 計算各點偏差:(4 − 6 = −2)、(8 − 6 = 2)、(6 − 6 = 0)、(5 − 6 = −1)、(7 − 6 = 1)。
- 將偏差平方:(−2)² = 4、2² = 4、0² = 0、(−1)² = 1、1² = 1。
- 求平方和:4 + 4 + 0 + 1 + 1 = 10。
- 計算變異數:
- 若視為總體:10 ÷ 5 = 2
- 若視為樣本:10 ÷ (5 − 1) = 2.5
- 開平方根求標準差:
- 總體標準差 σ = √2 ≈ 1.414
- 樣本標準差 s = √2.5 ≈ 1.581
標準差在各專業領域的實際應用
標準差並非純理論公式,它在各大行業決策中均扮演關鍵角色:
1. 投資理財與風險控管
在金融市場中,資產回報率的標準差常被用來衡量年化波動率(Volatility)。例如基金 A 與基金 B 過去十年的年化平均回報率皆為 7%,但基金 A 的標準差為 4%,基金 B 的標準差為 16%。基金 A 的年度表現相對平穩,而基金 B 則經歷過較劇烈的震盪。
評估投資效率的夏普比率(Sharpe Ratio)正是以超額回報除以標準差,藉此衡量承擔每單位波動風險所能換得的超額收益。(註:以上為示意數據,金融市場存在非對稱波動與肥尾效應,標準差反映歷史分散程度,非未來最大虧損預測,內容僅供教學參考,不構成投資建議。)
2. 工業製造與六標準差(Six Sigma)
依據美國品質學會(ASQ)之規範,企業推行六標準差管理方法,旨在將製程不良率壓低至每百萬次機會僅出現 3.4 次缺陷(3.4 DPMO)。製程標準差越小,品質分佈曲線越陡峭集中,超出規格容許上下限的機率便大幅降低。
根據 MoreSteam 等品質工程手冊說明,3.4 DPMO 的基準已考量長期製程均值可能發生 1.5σ 漂移的情形,對應的是規格界限與中心相距 4.5 個標準差的長期穩定表現。
3. 教育統計與考試評量
部分國際標準化考試(如 SAT、GRE)會在成績報告中公佈平均分與標準差,以利將考生原始分數轉換為標準分數(Z-score 或 T-score),客觀比對跨梯次的表現分佈。而在香港中學文憑考試(HKDSE)等公開考試中,官方成績發布主要採用等級分佈與累積百分比呈現,各類指標需以香港考試及評核局(HKEAA)公佈的官方統計為準。
4. 臨床醫學與生物統計
醫學研究報告常以「平均值 ± 標準差(Mean ± SD)」呈現試驗組與對照組的生理指標變化。標準差能清楚揭示受試者之間的個體反應變異程度,協助醫師判斷藥物效果是普遍穩定,還是存在高度個體差異。(註:本內容屬統計學科普,醫療診斷請遵循專業醫師指導。)
5. 氣象預測與環境監測
氣象部門分析特定月份氣溫或 PM2.5 濃度時,除公佈月平均值外,還會參考標準差。若某月份平均氣溫正常但標準差偏高,代表該月歷經劇烈溫差變化或極端氣候事件,單一平均數無法呈現這種劇烈起伏。
常態分佈下的經驗法則:68-95-99.7 法則
當數據分佈呈現對稱的鐘形曲線(即常態分佈 / 正態分佈)時,標準差與數據涵蓋範圍具有固定的統計關聯,通稱為「68-95-99.7 法則」:
| 分佈範圍 | 涵蓋數據比例 |
|---|---|
| 平均數 ± 1 個標準差(μ ± 1σ) | 約佔 68.27% |
| 平均數 ± 2 個標準差(μ ± 2σ) | 約佔 95.45% |
| 平均數 ± 3 個標準差(μ ± 3σ) | 約佔 99.73% |
使用前提提醒:該法則僅適用於近似對稱的常態分佈。若面對顯著偏斜的數據(如個人所得分配、房屋交易總價等偏態分佈),不可直接套用此法則,否則會產生嚴重推論偏誤。
標準差與其他離散指標之比較
評估數據離散程度時,常需與其他指標配合使用:
- 全距(Range):最大值減去最小值。計算最快,但僅取決於兩端極端值,容易受到極值扭曲。
- 四分位距(IQR):第 75 百分位數與第 25 百分位數之差。專注於中間 50% 的數據,對離群極端值具備極佳的耐受力,適合偏態數據。
- 變異係數(CV,Coefficient of Variation):標準差除以平均數的比值(CV = σ / μ)。標準差帶有單位,無法跨單位比較;變異係數為無量綱指標,適合用來比較單位不同或平均數懸殊之數據組的相對變異程度(例如比較大象體重與老鼠體重的相對波動)。
常見軟體與工具計算方式
主流數據分析軟體中,計算標準差的預設公式各有不同,使用時需特別留意:
- Microsoft Excel / Google 試算表:計算樣本標準差請使用
=STDEV.S()(分母為 n − 1);計算總體標準差請使用=STDEV.P()(分母為 N)。舊版=STDEV()運算邏輯等同於 STDEV.S。 - Python(NumPy):函式
numpy.std()預設參數為ddof=0,即預設計算總體標準差(除以 N)。若要計算樣本標準差,務必指定ddof=1。 - R 語言:內建函式
sd()預設計算樣本標準差(分母為 n − 1)。 - 科學型工程計算機:機身標示
σx(或σn)為總體標準差,標示sx(或sn-1)為樣本標準差。
數據解讀之三大檢查清單
在解讀各類統計報表時,可依循以下三步原則檢驗標準差:
- 確認數據分母基準:確認報告採用的是完整母體(除以 N)還是抽樣推論(除以 n − 1)。
- 檢視數據分佈型態:確認分佈是否接近常態分佈;若存在嚴重偏態,應同步參考中位數與四分位距(IQR)。
- 確認測量單位:切勿跨單位直接比對標準差數值,跨維度分析時請改用變異係數(CV)。
常見問題(FAQ)
Q1:標準差可以是負數嗎?
絕對不可以。標準差的計算核心是將各項離差進行「平方」,平方和必然大於或等於零;將非負數值取算術平方根後,結果必然為正數或零,絕不可能出現負值。
Q2:標準差等於零代表什麼意義?
標準差等於零代表該數據集中「所有數值完全相同」,彼此之間沒有任何離散與波動。例如檢驗五個零件直徑全為 10.0 毫米,離差平方和為零,標準差即為 0。
Q3:標準差數值越大代表越好還是越差?
標準差僅是客觀呈現波動幅度的統計量,並無絕對優劣,需視應用場景而定。在製造業品質控制與醫療劑量檢驗中,標準差越小代表穩定度越高、品質越佳;而在高風險投資策略中,較大的標準差代表資產價格彈性與波幅較大,伴隨較高的潛在獲利空間與下行風險。
Q4:標準差(SD)與標準誤(SE)有何區別?
標準差(Standard Deviation, SD)描述的是「單一樣本中個別原始數據點」的離散程度;標準誤(Standard Error, SE,常指樣本平均數標準誤 SEM = SD / √n)描述的是「多次抽樣所得之樣本平均數」的精準度與抽樣誤差。學術論文圖表中的誤差線需明確標示為 SD 或 SE,兩者不可混淆。
Q5:非對稱分佈或有離群值的數據能使用標準差嗎?
數學公式上依然可以計算,但在統計解讀上需格外謹慎。離差平方運算會大幅放大極端離群值的影響力,導致標準差顯著失真。若數據呈現高度偏態(例如財富分配數據),建議採用「中位數(Median)配合四分位距(IQR)」作為更穩健的統計描述方式。
